Kurz gesagt
- Ein Punkt pro Erwartung: Eine Erwartung ist eine Sache, die eine gute Antwort sagt oder tut, passend zur Frage und vor dem Interview festgelegt.
- Muss-Kriterien sind streng: nur das, ohne das Sie einen Kandidaten auf dieser Stufe ablehnen würden. Alles andere ist ein Kann-Kriterium.
- Drei bis sechs pro Block: Bei weniger entscheidet ein einziger Ausrutscher; bei mehr schafft die Antwort sie nicht alle in der Zeit.
- Im Code bewertet: In testee erhält jede Erwartung einen Status mit Zitaten; Muss-Kriterien zählen doppelt, und der Score dient der Prüfung, nicht als Einstellungsentscheidung.
- Es geht um den Job: nie um geschützte Merkmale, Ersatzmerkmale wie Berufsjahre oder Sprachfluss oder „Cultural Fit“.
Was eine Erwartung ist
Eine Erwartung ist ein Punkt, den eine gute Antwort abdeckt. Sie vor dem Interview zu schreiben und zwischen Muss- und Kann-Kriterien zu unterscheiden, macht aus einer Liste von Fragen einen Bewertungsleitfaden: Jeder Kandidat wird an denselben, vorab festgelegten Punkten gemessen.
- Pro Block. In testee hat jeder Block (eine Frage, eine Aufgabe oder ein Rollenspiel) eigene Erwartungen, und mindestens eine davon ist ein Muss-Kriterium.
- Zwei Stufen. Ein Muss-Kriterium ist zentral: Ohne es würden Sie einen Kandidaten ablehnen. Ein Kann-Kriterium bringt Zusatzpunkte.
- Für Kandidaten verborgen. Erwartungen erreichen nie den Browser des Kandidaten, und der KI-Interviewer verrät sie auch auf Nachfrage nicht.
- Mit Belegen bewertet. Nach jedem Block gibt die KI-Analyse jeder Erwartung einen Status und zitiert die genauen Worte des Kandidaten, auf denen er beruht.
- Quizze werden berechnet. Das Muss-Kriterium „Richtig beantwortet“ eines Quiz ergibt sich aus den gewählten Optionen, nicht aus der KI; die übrigen Erwartungen bewerten die Erklärung des Kandidaten.
So funktionieren Status und Abdeckungs-Score
| Status | Bedeutung | Zählt als |
|---|---|---|
| Abgedeckt | Klar und korrekt behandelt, ohne darauf hingewiesen zu werden | Voll |
| Teilweise | Erwähnt, aber oberflächlich oder unvollständig | Halb |
| Nach Nachfrage abgedeckt | Erst behandelt, nachdem der Interviewer einen Hinweis darauf gegeben hat | Halb |
| Falsch | Behandelt, aber mit einem sachlichen Fehler | Nichts |
| Nicht abgedeckt | Nicht behandelt | Nichts |
Der Abdeckungs-Score von 0 bis 100 wird im Code aus diesen Status berechnet, nie von der KI, und ein Muss-Kriterium zählt doppelt so viel wie ein Kann-Kriterium. Nehmen Sie einen Block mit drei Muss- und zwei Kann-Kriterien. Der Kandidat deckt zwei Muss-Kriterien ab, antwortet beim dritten teilweise, deckt ein Kann-Kriterium ab und verfehlt das andere: 2 + 2 + 1 + 1 + 0 = 6 von 8 Punkten, ein Score von 75.
Der Bericht zeigt außerdem, ob jedes Muss-Kriterium erfüllt wurde (abgedeckt oder nach Nachfrage abgedeckt). In diesem Beispiel nicht: Die Teilantwort zählt nicht. Der Gesamtscore des Interviews kombiniert die Blöcke, jeweils gewichtet nach ihren Erwartungen, sodass ein Block mit mehr Erwartungen stärker zählt. Ein Prüfer kann jeden Status von Hand ändern, und der Score ist als „zur Prüfung, keine Einstellungsentscheidung“ gekennzeichnet (Gebrauchsanweisung).
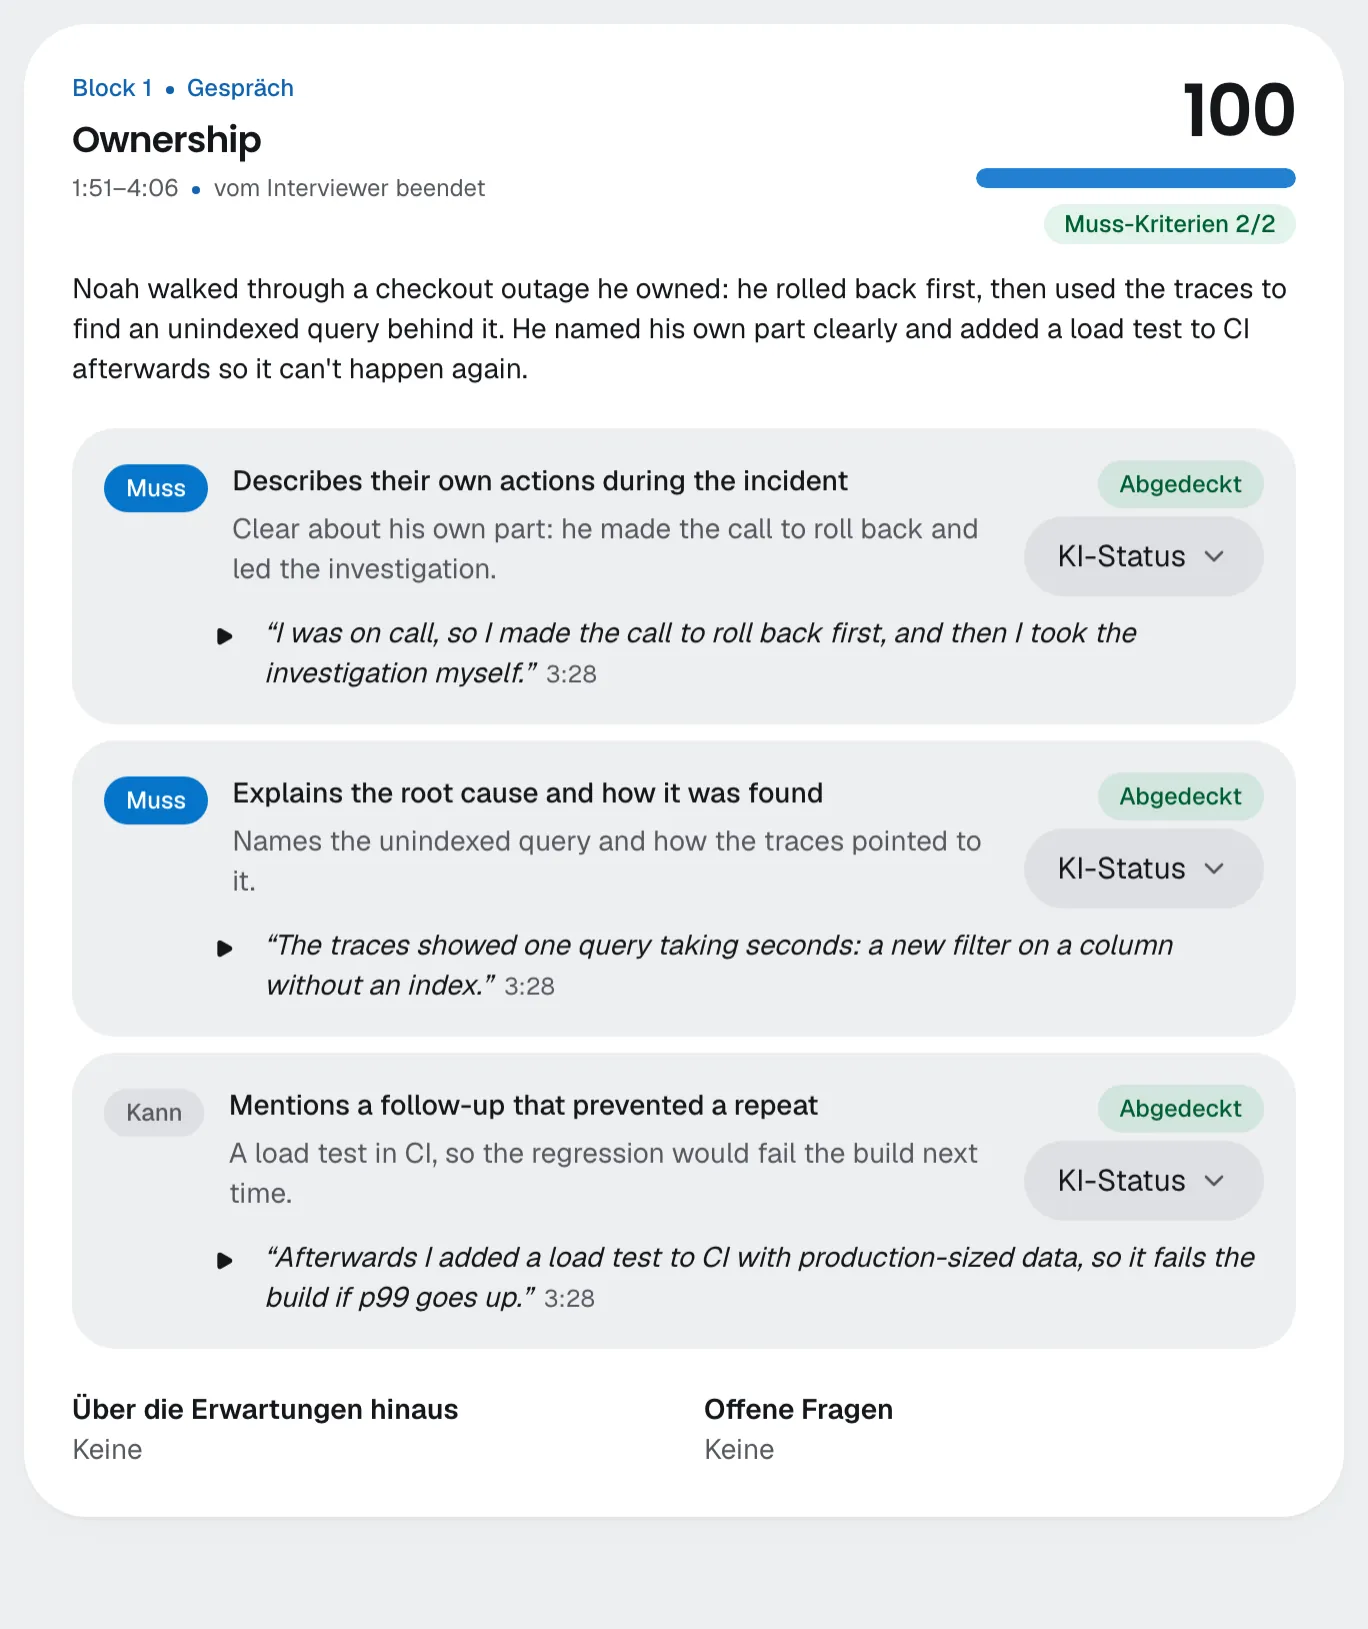
Jeden Punkt einzeln zu bewerten und nach einer festen Regel zusammenzuzählen, ist Absicht. Über viele Studien hinweg sagte die Kombination von Bewertungen per Formel die Arbeitsleistung besser voraus als Experten, die sie im Kopf kombinierten: eine mittlere Validität von .44 gegenüber .28 (Kuncel et al. 2013). Wie Sie das Ergebnis lesen, steht in So lesen Sie einen KI-Interview-Bericht.
Ein Bewertungsleitfaden, den man in der Antwort sieht
Eine gute Erwartung beschreibt etwas, das der Kandidat sagt oder tut, passend zur Frage, sodass zwei Prüfer bei derselben Antwort zum selben Status kommen. Skalen, die vorab beschreiben, was eine gute Antwort enthält, gehen auf Smith & Kendall (1963) zurück; mit ihnen stimmen Interviewer in ihren Bewertungen gut überein (Taylor & Small 2002).
- Ein Punkt pro Erwartung. „Prüft die Logs und rollt das Release zurück“ sind zwei Prüfungen; teilen Sie sie auf.
- Eine Handlung oder Aussage. Beginnen Sie mit einem Verb: nennt, erklärt, fragt, prüft, räumt ein.
- Passend zur Frage. „Speichert Zeiten in UTC und rechnet sie nur für die Anzeige um“, nicht „kennt sich mit Datumsverarbeitung aus“.
- Kurz. Höchstens etwa 20 Wörter.
- Beispiele, wenn mehrere Antworten zählen. „Bietet einen Workaround an (eine Einstellung, einen Export, einen manuellen Schritt)“: Einer, gut ausgeführt, genügt.
| Vage | Warum es scheitert | Beobachtbar |
|---|---|---|
| Gute Kommunikation | Keine zwei Prüfer sind sich darin einig | Fasst das Problem des Kunden in einem Satz zusammen, bevor er antwortet |
| Starke technische Fähigkeiten | Nicht an die Frage gebunden | Nennt, wo im System die Zeitzone verloren geht |
| Kundenorientiert | Eine Eigenschaft, keine Handlung | Fragt, wie der Kunde die Funktion nutzt, bevor er eine Alternative vorschlägt |
| Versteht Vertrieb | In einer einzelnen Antwort nicht sichtbar | Geht durch, was bei der Demo vereinbart wurde, bevor er nachfasst |
| Gutes Produktgespür | Zu breit | Nutzt Nutzungsdaten, um herauszufinden, wo Nutzer abspringen |
| Kommt gut mit Druck zurecht | Ein Urteil über die Persönlichkeit | Sagt, was er dem Kunden gesagt hat, als sich ein zugesagter Termin verschob |
Wie viele Erwartungen pro Block
Drei bis sechs für die meisten Blöcke. Bei weniger entscheidet ein einziger Ausrutscher über den ganzen Block; bei mehr bleiben jedem Punkt nur ein paar Sekunden, und die Antwort schafft nicht alle in der Zeit.
| Block | Übliche Anzahl |
|---|---|
| Gespräch, 4–5 Min. | 3–5 |
| Quiz, 1–2 Min. | 2: richtig beantwortet, plus was die Erklärung abdecken sollte |
| Rollenspiel oder Schreibaufgabe, 8–10 Min. | 4–6 |
| Programmieraufgabe, Review oder Whiteboard, 12–15 Min. | 5–8; ein Review erhält eine pro eingebautem Problem |
Da der Gesamtscore jeden Block nach seinen Erwartungen gewichtet, zählt ein Block mit acht mehr als einer mit drei. Geben Sie den wichtigsten Fähigkeiten die meisten Erwartungen.
Muss- und Kann-Kriterien: Seien Sie streng
Ein Muss-Kriterium ist ein Punkt, bei dessen Fehlen Sie einen Kandidaten auf dieser Stufe ablehnen würden. Alles andere ist ein Kann-Kriterium. Das US-Behindertenrecht zieht eine ähnliche Grenze zwischen den wesentlichen Funktionen einer Stelle und dem Rest (29 CFR 1630.2), und das ist für jede Rolle eine gute Gewohnheit.
Vier Fragen für jedes Muss-Kriterium
- Ablehnung: Würden Sie einen ansonsten starken Kandidaten wirklich ablehnen, dem das fehlt?
- Stufe: Wird es auf dieser Seniorität erwartet? Ein Junior muss keine Monitoring-Tools nennen, ein Senior schon.
- Erlernbar: Könnte er es im ersten Monat lernen? Dann ist es ein Kann-Kriterium.
- Beantwortbar: Lädt die Frage dazu ein? Einen Punkt, nach dem die Frage nie fragt, werden auch gute Kandidaten verfehlen.
Sind die meisten Erwartungen eines Blocks Muss-Kriterien, prüfen Sie jede noch einmal. Kann-Kriterien lassen starke Kandidaten mehr zeigen, ohne die übrigen zu benachteiligen.
Erwartungen beim Job halten
Eine Erwartung muss sich darauf beziehen, was der Job verlangt, nie darauf, wer der Kandidat ist. Achten Sie auch auf Ersatzmerkmale: Begriffe, die nach Job klingen, aber für Alter, Herkunft, Behinderung oder Persönlichkeit stehen.
| Vermeiden | Das Problem | Stattdessen schreiben |
|---|---|---|
| Cultural Fit | Undefiniert, belohnt also Menschen, die dem Interviewer ähneln | Das Verhalten, das Sie schätzen: „Nennt ein Beispiel, wie er seinen Plan nach dem Feedback eines Kollegen geändert hat“ |
| Selbstbewusst, energiegeladen | Ein Urteil über die Persönlichkeit | „Gibt eine Empfehlung und den Grund dafür an“ |
| 10+ Jahre Erfahrung | Ein Ersatzmerkmal für Alter, nicht für Können | „Erklärt, warum er sich in einer verantworteten Funktion für einen Ansatz statt eines anderen entschieden hat“ |
| Englisch als Muttersprache | Ein Ersatzmerkmal für Herkunft | Wenn Schreiben auf Englisch zum Job gehört: „Schreibt eine Antwort, der ein Kunde ohne Fachjargon folgen kann“ |
| Spricht flüssig, ohne Zögern | Benachteiligt Akzent, Stottern und Nervosität | Bewerten Sie den Inhalt der Antwort, nicht ihren Vortrag |
In testee bewertet die Analyse nur die Abdeckung: Sie beurteilt weder Persönlichkeit, Akzent, Sprachfluss, Selbstbewusstsein noch „Cultural Fit“ und analysiert nie Emotionen, Stimme oder Gesichter. Die Generierung lehnt Fragen zu geschützten Merkmalen ab, und vom Unternehmen geschriebene Texte werden beim Veröffentlichen darauf geprüft. Kandidaten, die nicht sprechen können oder möchten, können jede Antwort tippen; schreiben Sie Erwartungen also darüber, was gesagt wird, nicht wie. Mehr unter faire KI-Interviews.
Beispiele für Einstellungskriterien in vier Rollen
Ein Gesprächsblock pro Rolle, je etwa fünf Minuten, mit Erwartungen nach den Regeln oben. Nutzen Sie sie als Vorbild, nicht als fertiges Interview.
Softwareentwickler: ein Zeitzonen-Bug
„Nutzer in anderen Ländern melden, dass eine Seite Ihrer App die falsche Uhrzeit für ihre Buchungen anzeigt. Wie würden Sie den Fehler aufspüren und beheben?“
| Erwartung | Stufe |
|---|---|
| Prüft, wo die Zeit gespeichert und wo sie umgerechnet wird (Datenbank, Server, Browser) | Muss-Kriterium |
| Speichert oder sendet Zeiten in UTC mit explizitem Offset und rechnet nur für die Anzeige um | Muss-Kriterium |
| Testet die Korrektur in mindestens zwei Zeitzonen, einschließlich einer Sommerzeitumstellung | Muss-Kriterium |
| Nutzt die Zeitzonen-Unterstützung der Plattform oder eine Datumsbibliothek statt manueller Offsets | Kann-Kriterium |
| Prüft andere Ansichten und Berichte auf denselben Bug | Kann-Kriterium |
Kundensupport: eine verschwundene Funktion
„Ein Kunde schreibt, dass eine Funktion, die er täglich nutzt, seit dem gestrigen Update verschwunden ist. Sie wissen nicht, ob sie absichtlich entfernt wurde. Wie antworten Sie?“
| Erwartung | Stufe |
|---|---|
| Klärt vor der Antwort, ob die Änderung beabsichtigt war (Release Notes, Produktteam) | Muss-Kriterium |
| Sagt dem Kunden ehrlich, was bekannt ist und wann er mehr erfährt | Muss-Kriterium |
| Bietet einen Workaround oder eine Alternative an, falls es eine gibt | Muss-Kriterium |
| Gibt den Anwendungsfall des Kunden an das Produktteam weiter | Kann-Kriterium |
| Prüft, ob andere Kunden dasselbe gemeldet haben | Kann-Kriterium |
Vertrieb: ein Interessent, der sich nicht mehr meldet
„Nach einer gut gelaufenen Demo hat ein Interessent seit drei Wochen nicht geantwortet. Was tun Sie?“
| Erwartung | Stufe |
|---|---|
| Geht vor der Kontaktaufnahme durch, was bei der Demo vereinbart wurde und wer entscheidet | Muss-Kriterium |
| Fasst mit etwas nach, das dem Interessenten nützt, nicht nur mit „Ich wollte mich mal melden“ | Muss-Kriterium |
| Versucht einen anderen Kontakt im Account, wenn der Hauptkontakt weiter schweigt | Muss-Kriterium |
| Legt einen Punkt fest, an dem er die Opportunity schließt und weitermacht | Kann-Kriterium |
| Fragt den Interessenten direkt, ob sich seine Prioritäten geändert haben | Kann-Kriterium |
Produktmanager: eine Funktion, die niemand nutzt
„Eine Funktion, die Ihr Team vor einem Monat eingeführt hat, wird kaum genutzt. Was tun Sie?“
| Erwartung | Stufe |
|---|---|
| Wertet Nutzungsdaten aus, um herauszufinden, wo Nutzer abspringen | Muss-Kriterium |
| Spricht mit Nutzern, sowohl mit denen, die die Funktion ausprobiert haben, als auch mit den anderen | Muss-Kriterium |
| Entscheidet begründet zwischen Verbessern, Neupositionieren oder Entfernen | Muss-Kriterium |
| Nennt die Erfolgskennzahl, die vor dem Launch hätte festgelegt werden sollen | Kann-Kriterium |
| Teilt die Erkenntnisse mit dem Team und den Stakeholdern | Kann-Kriterium |
Checkliste vor dem Veröffentlichen
Für jeden Block
- Drei bis sechs Erwartungen, mehr bei langen Aufgaben, jede ein Punkt.
- Beobachtbar: Jede beginnt mit einem Verb und nennt etwas Gesagtes oder Getanes.
- Spezifisch: Jede könnte nur zu dieser Frage gehören.
- Mindestens ein Muss-Kriterium, und jedes besteht die Tests zu Ablehnung, Stufe und Erlernbarkeit.
- Die Frage lädt zu jeder Erwartung ein; nichts ist eine versteckte Falle.
- Nichts darüber, wer der Kandidat ist: keine geschützten Merkmale, Ersatzmerkmale, Persönlichkeit oder Vortragsweise.
- Gewicht entspricht Wichtigkeit: Die zentralen Fähigkeiten haben die meisten Erwartungen.
Zusammenfassung
- Eine Erwartung ist ein beobachtbarer Punkt, den eine gute Antwort abdeckt, vor dem Interview festgelegt und für Kandidaten verborgen.
- Muss-Kriterien sind nur das, ohne das Sie einen Kandidaten ablehnen würden; der Rest sind Kann-Kriterien.
- In testee erhält jede Erwartung einen Status mit Zitaten, und der Score, im Code berechnet mit doppelt gezählten Muss-Kriterien, dient der Prüfung, nicht als Einstellungsentscheidung.
- Schreiben Sie über den Job und den Inhalt der Antwort, nie über die Person oder ihre Sprechweise.
Fragen und Antworten
Was ist der Unterschied zwischen Muss- und Kann-Kriterien?
Ein Muss-Kriterium ist etwas, ohne das Sie einen Kandidaten auf dieser Stufe ablehnen würden. Ein Kann-Kriterium stärkt die Bewerbung, sein Fehlen schließt den Kandidaten aber nicht aus. Halten Sie Muss-Kriterien wenige und streng.
Was sind Beispiele für Muss- und Kann-Kriterien bei einer Stelle?
Für eine Support-Rolle ist „sagt dem Kunden ehrlich, was bekannt ist und wann er mehr erfährt“ ein Muss-Kriterium und „gibt den Anwendungsfall an das Produktteam weiter“ ein Kann-Kriterium. Für einen Entwickler, der einen Zeitzonen-Bug behebt, ist das Speichern von Zeiten in UTC ein Muss-Kriterium; andere Ansichten auf denselben Bug zu prüfen, ist ein Kann-Kriterium.
Wie erstellt man einen Bewertungsleitfaden für Interviews?
Wählen Sie die Fähigkeiten, die der Job verlangt, schreiben Sie eine Frage pro Fähigkeit und listen Sie dann drei bis sechs beobachtbare Punkte auf, die eine gute Antwort abdeckt, jeweils als Muss- oder Kann-Kriterium markiert. Legen Sie sie vor dem ersten Interview fest und messen Sie jeden Kandidaten an derselben Liste.
Wie sieht ein Bewertungsleitfaden aus?
Eine Liste pro Frage: Jede Zeile ist ein Punkt, den eine gute Antwort abdeckt, mit seiner Stufe und nach dem Interview einem Status samt Beleg. Die Beispiele oben für vier Rollen zeigen echte Leitfäden.
Sehen Kandidaten die Erwartungen?
Nicht in testee: Sie erreichen nie den Browser des Kandidaten, und der Interviewer verrät sie nicht. Kandidaten sehen jede Frage oder Aufgabe sowie die Teile und die Dauer des Interviews.
Quellen
- Kuncel, Klieger, Connelly & Ones (2013), Mechanical versus clinical data combination in selection and admissions decisions
- Smith & Kendall (1963), Retranslation of expectations
- Taylor & Small (2002), Asking applicants what they would do versus what they did
- ADA-Vorschriften, 29 CFR 1630.2 (wesentliche Funktionen)
- testee, Gebrauchsanweisung (wie der Abdeckungs-Score berechnet wird)